データ基盤を整える:分析以前のデータ整備の実務
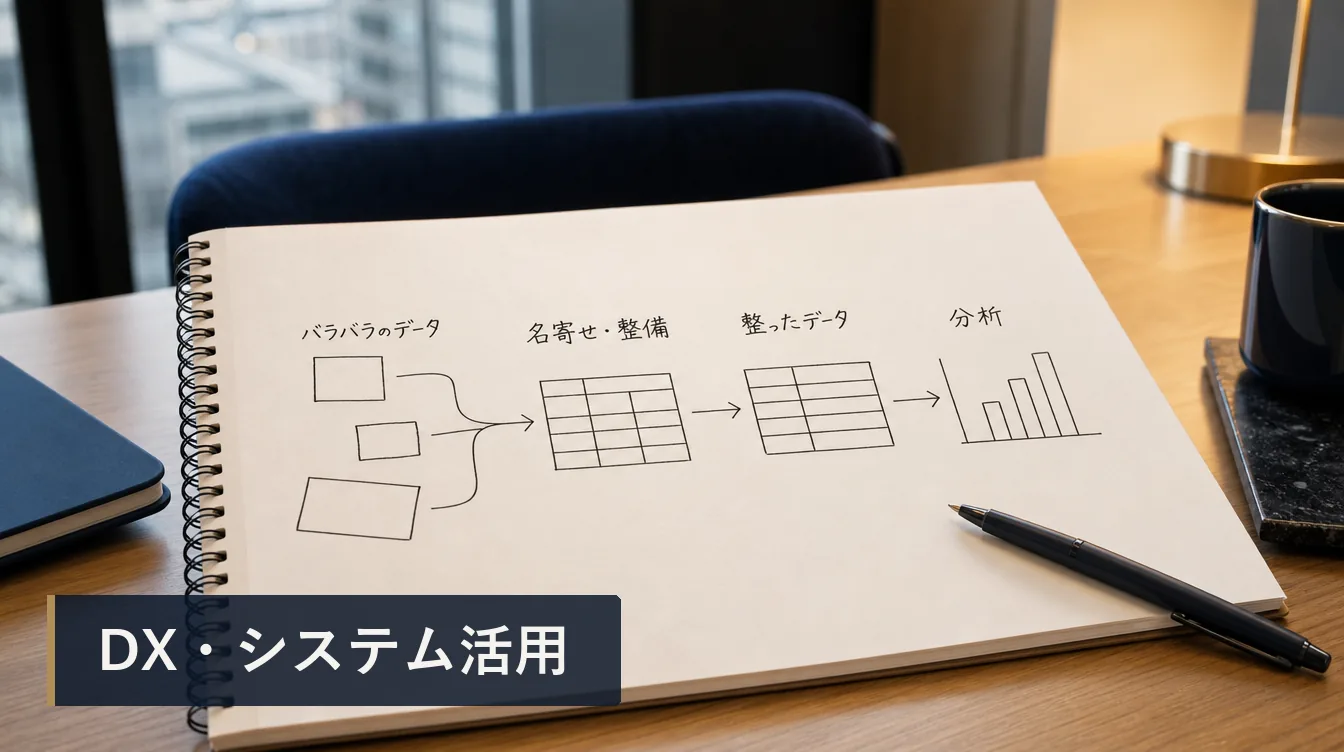
「データを分析して経営に活かしたい」と考えても、いざ着手すると分析そのものより手前でつまずく企業が少なくありません。部署ごとにデータが散らばり、同じ顧客が別々に登録され、項目の定義もそろっていない——この状態では、どれほど優れた分析ツールやAIを導入しても正しい答えは得られません。本記事では、分析やAI活用の前段にある「データ整備」の実務を、品質の考え方と具体的な進め方の両面から整理します。
なぜ「分析以前」でつまずくのか
分析やAI活用の成否は、ツールの性能よりも入り口にあるデータの状態で大きく変わります。総務省の「令和6年版 情報通信白書」でも、AIの開発・活用を支える基盤として、計算資源とあわせて大量・高品質なデータの整備の重要性が示されています。元になるデータが整っていなければ、どんな仕組みも期待どおりには働きません。
ところが多くの現場では、分析を始めようとした段階で初めてデータの問題に気づきます。表計算ファイルが部署ごとに点在し、どれが最新版か分からない。手作業で集計し直すうちに、分析に入る前に力尽きてしまう——これは珍しい話ではありません。
現場でよく起きる3つの詰まり
- サイロ化:部署やシステムごとにデータが分断され、横断して見られない
- 表記ゆれ:「株式会社ノアブリッジ」と「(株)ノアブリッジ」が別の取引先として登録されている
- 定義の不一致:同じ「売上」でも、税込か税抜か、計上のタイミングが部署ごとに違う
これらはいずれも、分析の直前になって表面化します。数字が合わない原因を一つずつ追ううちに、本来やりたかった分析にたどり着けない。だからこそ、分析の前に「データを整える」工程を独立した仕事として設計する必要があります。
データの品質は何で測るのか
整備に入る前に、「良いデータ」とは何かを言葉にしておきましょう。デジタル庁は、行政機関のあいだでデータをやり取りするための「政府相互運用性フレームワーク(GIF)」の一部として「データ品質管理ガイドブック」を公開しており、国際規格ISO/IEC 25012を踏まえて品質特性を整理しています。民間企業が自社のデータを点検するうえでも参考になります。
まず押さえる3つの基礎的品質特性
- 正確性:データに誤りがなく、表すべき現実を正しく表しているか
- 完全性:必要な項目に欠落がなく、そろっているか
- 一貫性:データ間で矛盾がなく、整合が取れているか
同ガイドブックでは、この正確性・完全性・一貫性を「基礎的品質特性」と位置づけ、さらに「最新性(データが必要な時点の状態に保たれているか)」などを付加的な特性として挙げています。IPA(情報処理推進機構)も、質の高いデータを「正確かつ最新であり、抜け漏れやバイアスのないデータ」と説明しており、押さえるべき観点は共通しています。
こうした物差しを先に共有しておくと、現場での議論が具体的になります。「このデータは使えない」という曖昧な感覚ではなく、「完全性に欠ける(必要な期間の記録が抜けている)」「一貫性がない(単位が部署ごとに違う)」といった形で、どこをどう直せばよいかが見えるようになるからです。国際規格に沿った共通の言葉を持つことが、整備の第一歩になります。
分析以前のデータ整備 5つのステップ
「良いデータ」の物差しが決まったら、実際の整備に入ります。闇雲に手を動かすのではなく、次の順序で進めると迷いが減ります。
- 目的と問いを先に決める:何を知りたいかで、必要なデータの範囲と粒度が決まる。目的があいまいなまま集め始めると、使わないデータの整備に時間を浪費する
- データの棚卸し:どこに、どんな形式で、誰が持っているデータがあるかを一覧にする。所在と管理者が分かるだけで、以降の作業が一気に進めやすくなる
- クレンジングと名寄せ:表記ゆれの統一、重複レコードの排除、欠損値の扱いを決める。同じ実体を指すデータを一つにまとめる「名寄せ」が精度を左右する
- マスタデータとコードの統一:顧客・商品・組織といった基準になる情報を一本の基準表(マスタ)にそろえ、部署ごとにばらばらだったコードを統一する
- メタデータ・データ辞書の整備:各項目の定義・意味・単位・更新頻度を記録する。「この列が何を表すか」を文書化しておくと、担当者が替わっても使い続けられる
たとえば名寄せでは、「株式会社」と「(株)」、全角と半角、部署名の有無といった表記の違いを一つのルールで統一します。この作業を飛ばすと、本来は同じ顧客なのに売上が二重・三重に分かれて集計され、ランキングも構成比も狂ってしまいます。地味ですが、ここでの精度が分析結果の信頼性を直接左右します。
特に見落とされがちなのが最後のメタデータです。IPAもデータ辞書やコード表の整備を重視しており、項目の意味がそろって初めて、別々のデータをつなげて分析できるようになります。「顧客ID」が何を指すのか、いつ時点の値なのかが共有されていなければ、せっかく整えたデータも別のデータと安全に結び付けられません。
小さく始めて運用に乗せる
全社のデータを一度に整えようとすると、範囲が広すぎて挫折しがちです。まずは一つの分析テーマ——たとえば「主要顧客別の売上推移を正しく見る」——に絞り、そのテーマに必要なデータだけを整えるところから始めます。小さな成功体験が、次のテーマへの推進力になります。
続けるための3つのポイント
- データのオーナーを決める:項目ごとに責任者を明確にし、「誰が正とするか」を曖昧にしない
- 公的なオープンデータを活用する:e-Statなどの公開データや標準的なコード表を使えば、自前でゼロから整える負担を減らせる
- 整備を一度きりにしない:更新のルールと担当を決め、日々の業務の中でデータが保たれる仕組みに組み込む
データ整備は地味で成果が見えにくい工程ですが、ここを飛ばした分析は砂上の楼閣になります。分析やAI活用を検討する前に、まず自社のデータがどんな状態かを点検することが、遠回りに見えて最短の道です。
この記事のまとめ
- 分析・AI活用の精度は、ツールよりも入り口のデータの状態で決まる
- 品質は正確性・完全性・一貫性を基礎に、用途に対して十分かで判断する
- 整備は「目的→棚卸し→クレンジング・名寄せ→マスタ統一→メタデータ」の順で進める
- 全社一斉ではなく一つのテーマから小さく始め、オーナーと更新の仕組みで定着させる
よくある質問
データ整備は、分析ツールやBIを導入する前にやるべきですか?
原則として先に、あるいは並行して進めることをおすすめします。入り口のデータに不備があると、高機能なツールでも誤った結果を出してしまうためです。ただし全データを完璧にしてから、と考えると前に進まないので、最初の分析テーマに必要な範囲から整えるのが現実的です。
データの品質はどこまで高めれば十分ですか?
用途に対して十分かどうかが判断基準です。デジタル庁のガイドブックも正確性・完全性・一貫性を基礎的な品質特性としていますが、求める水準は目的によって変わります。重要な意思決定に使うデータほど高い品質が必要で、試行段階ならある程度の不備は許容できます。
中小企業でも大がかりなデータ基盤は必要ですか?
必ずしも大規模なシステムは必要ありません。まずは表計算ソフトのデータでも、表記や定義をそろえ、項目の意味を記録するだけで分析の土台は大きく改善します。扱う量や関係者が増えてきた段階で、段階的に基盤を検討すれば十分です。
ノアブリッジでは、DX・システム活用や業務改革の視点から、データ活用の前段にある整備や進め方のご相談を承っています。自社の状況に合わせた始め方を検討したい方は、各事業ページよりお気軽にお問い合わせください。
支援の具体例 → ノアブリッジの導入事例を見る