AI導入のためのデータ整備:使えるデータと使えないデータ
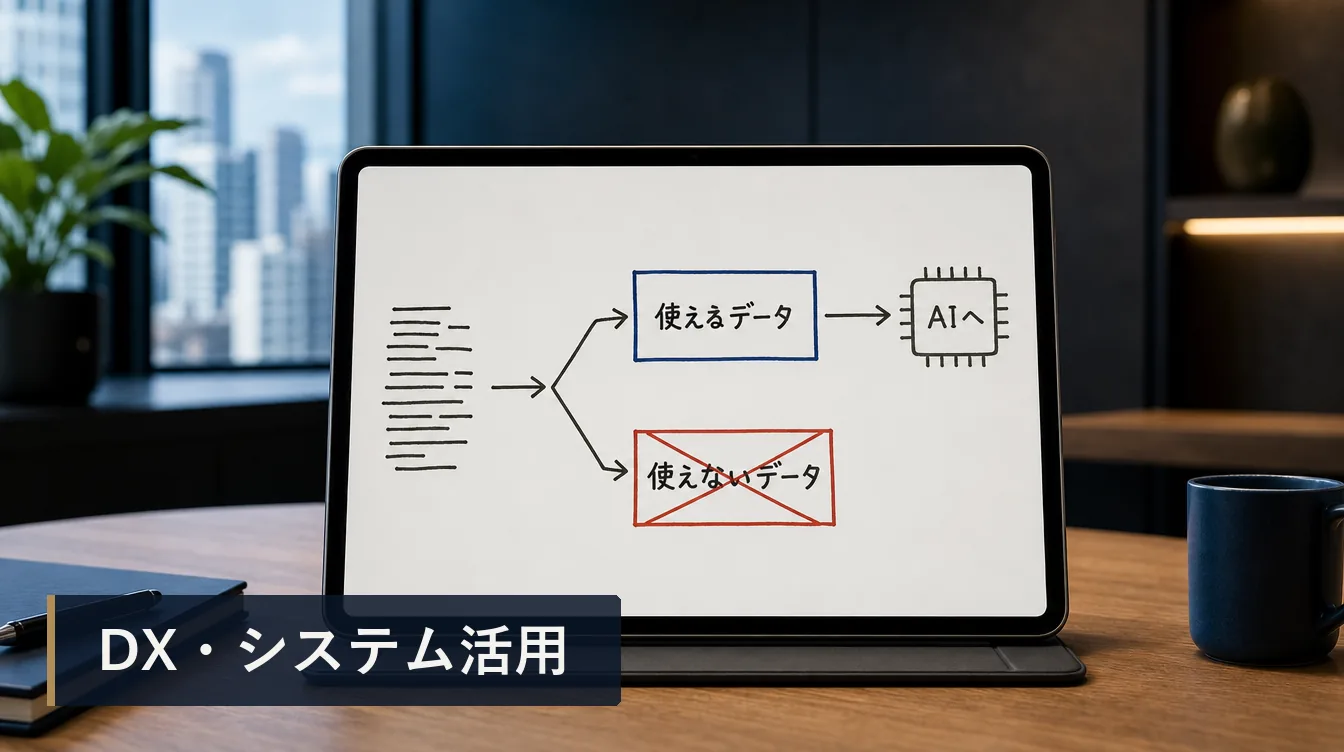
AIツールを導入したのに、期待した精度が出ない――その原因の多くは、AIそのものではなく「食べさせるデータ」の側にあります。どれだけ高性能なモデルでも、元になるデータが不正確で断片的なら、出てくる答えも信頼できません。本記事では、AI導入で成果を出すための土台となる「データ整備」について、使えるデータと使えないデータの見分け方、品質を測る視点、整備の進め方、そして見落としがちな法務・ガバナンスの論点までを、中小・中堅企業の実務目線で整理します。
なぜAI導入は「データ整備」でつまずくのか
生成AIやAI分析ツールの導入は急速に広がっています。総務省の令和7年版情報通信白書によると、生成AIの活用方針を定めた企業の割合は2024年度で49.7%に達し、前年度の42.7%から増加しました。一方で、企業規模別に見ると大企業と中小企業の間には差があり、方針づくりや活用の進度に開きが生じています。
こうした導入の場面でつまずきの原因になりやすいのが、AIに与えるデータの質です。「ゴミを入れれば、ゴミが出てくる(Garbage In, Garbage Out)」という言葉が示すとおり、入力データの品質は出力の品質をそのまま左右します。実際、データ分析の現場では「作業時間の8割が前処理」と言われるほど、生のデータを使える状態に整える工程は重く、地道な作業です。
「使えるデータ」と「使えないデータ」を分ける6つの視点
データが「使えるかどうか」は感覚ではなく、いくつかの観点で分解して判断できます。データマネジメントの知識体系であるDMBOKでは、データ品質を測る代表的な評価軸が整理されています。ここでは実務で確認しやすい6つの視点に絞って紹介します。
- 正確性:値が現実を正しく表しているか(誤入力・古い住所・桁違いの金額などがないか)
- 完全性:必要な項目が欠けずに揃っているか(空欄・未入力の多さ)
- 一貫性:同じ意味の項目が同じ形式で記録されているか(表記ゆれ・単位の不統一)
- 一意性:同じ対象が重複して登録されていないか(顧客の二重登録など)
- 適時性:判断に使うのに十分新しいか(更新が止まっていないか)
- 妥当性:あらかじめ決めた形式やルールに沿っているか(日付・コードの型)
「使えないデータ」とは、これらの視点で問題を抱えたデータです。逆に言えば、この6つを満たすように整えていけば、AIにも人にも信頼される土台に近づきます。すべてを一度に完璧にする必要はなく、AIで解きたい課題に直結する項目から優先的に整えるのが現実的です。
使えないデータの典型パターンと直し方
現場でよく見かける「使えないデータ」には、いくつかの決まったパターンがあります。原因を知ると、直し方も見えてきます。
表記ゆれ・フォーマットの不統一
「株式会社」と「(株)」、全角と半角、西暦と和暦が混在していると、集計もAIの学習も正しく行えません。入力ルールを定め、既存データはクレンジング(名寄せ・正規化)で揃えます。まず新規入力のルールを固め、蛇口を締めてから過去分を直すと、いたちごっこを防げます。
欠損・空欄の放置
必須のはずの項目が空のままだと、AIはそのレコードをうまく扱えません。欠損の割合を把握し、補完するのか、対象から外すのかを項目ごとに決めます。何をもって「入力済み」とするかの定義を、担当者間で揃えておくことが再発防止になります。
散らばったサイロ・エクセルの属人管理
部門ごとに別々のエクセルで管理され、同じ顧客が違う形で登録されている状態では、全社の実態をAIに正しく渡せません。まずどこに何のデータがあるかを棚卸しし、統合の優先順位を付けます。システム間でデータをやり取りする仕組みづくりは、データ整備と両輪の関係にあります。
AIに載せる前に整える実践ステップ
データ整備は、いきなり全社データを完璧にしようとすると挫折します。AIで解きたい課題を起点に、小さく回すのが定石です。
- 目的を先に決める:AIで何を判断・自動化したいかを一つに絞り、そのために必要なデータを特定する
- 対象データを棚卸しする:どこに、どの粒度で、いつのデータがあるかを一覧化する
- 品質を診断する:欠損率・重複・表記ゆれを実際に測り、問題の大きさを可視化する
- 入力ルールと定義を整える:項目の意味・必須条件・形式を決め、新規入力から適用する
- クレンジングする:名寄せ・正規化・欠損処理を、優先度の高い項目から実施する
- 小さく試して検証する:整えたデータで一度AIを動かし、精度と使い勝手を確かめてから広げる
この一連の流れは、データドリブンな意思決定の土台づくりとも重なります。完璧な基盤を待つのではなく、使いながら育てる発想が、結果的に定着への近道になります。
データ整備で外せない法務・ガバナンスの視点
データを整えて活用する際は、品質だけでなく「扱ってよいデータか」という観点も欠かせません。特に個人情報を含むデータをAIに入力する場合は注意が必要です。
個人情報保護委員会は2023年6月に、生成AIサービスの利用に関する注意喚起を公表しています。そこでは、個人情報を取り扱う事業者が、特定した利用目的の達成に必要な範囲を超えて個人情報を取り扱うことのないよう求められており、本人の同意なく個人データを応答結果の出力以外の目的で扱う場合、法に違反する可能性があると指摘されています。自社データをAIに載せる前に、その利用目的が当初の取得目的の範囲内かを確認しておくことが大切です。
なお、法務・労務・税務にかかわる判断は個別事情によって結論が変わります。ここでは一般的な考え方を示すにとどめ、具体的な取り扱いは弁護士など専門家への相談をおすすめします。あわせて、誰がどのデータをどこまで使ってよいかという社内ルール(データガバナンス)を整えておくと、活用のスピードと安全性を両立できます。
AI導入の成否は、モデル選びの前に「自社のデータをどこまで信頼できるか」で半分決まっている。
この記事のまとめ
- AIの精度は、モデルの性能より入力データの品質に大きく左右される。まずデータの点検から始める
- 使えるデータかは、正確性・完全性・一貫性・一意性・適時性・妥当性の6つの視点で分解して判断できる
- 表記ゆれ・欠損・サイロ化が典型的な「使えない」パターン。新規入力のルールを固めてから過去分を直すと効率的
- 整備は目的を一つに絞って小さく回す。個人情報を扱う場合は利用目的の範囲とデータガバナンスを必ず確認する
よくある質問
AI導入の前に、まず何から手を付ければよいですか?
全社データの整備より先に、AIで解きたい課題を一つに絞ることをおすすめします。目的が決まれば必要なデータが特定でき、その範囲だけを棚卸し・診断・クレンジングすればよいため、小さく早く始められます。
「使えないデータ」とは具体的にどんなデータですか?
誤入力や古い値がある(正確性)、必要項目が空欄(完全性)、表記や単位がバラバラ(一貫性)、同じ対象が重複登録されている(一意性)、更新が止まっている(適時性)、決めた形式に沿っていない(妥当性)データです。これらはAIの出力精度を下げます。
個人情報を含むデータをAIに使ってもよいですか?
一律に禁止されるわけではありませんが、注意が必要です。個人情報保護委員会は、特定した利用目的の範囲を超えて個人情報を取り扱わないよう求めています。当初の取得目的の範囲内かを確認し、判断に迷う場合は専門家に相談してください。
AI活用に向けたデータ整備の進め方や、自社データの現状診断についてお悩みがあれば、ノアブリッジのコンサルティング・DX支援がお手伝いします。まずはお気軽にご相談ください。
支援の具体例 → ノアブリッジの導入事例を見る